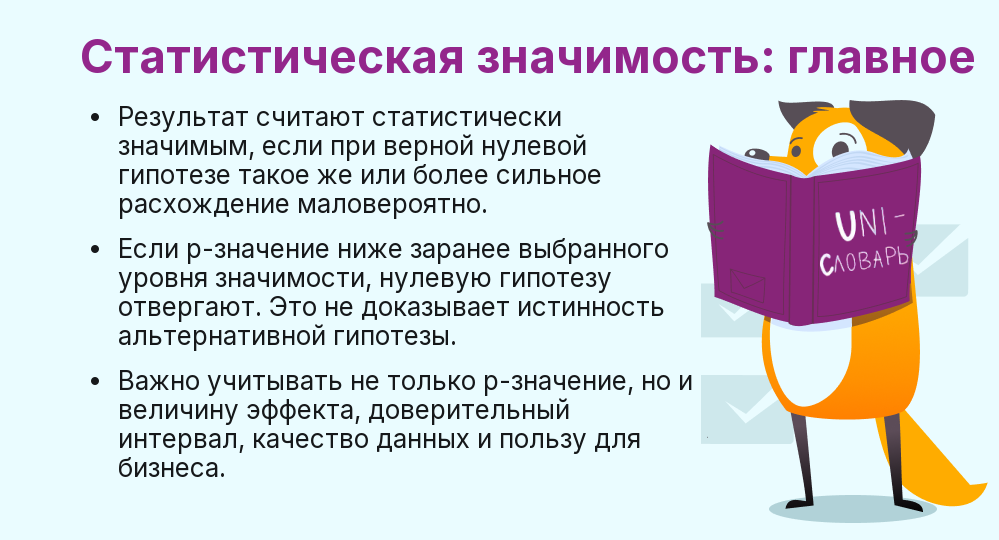
Статическая значимость — это показатель, который помогает понять, случайно ли различаются два набора данных. Если такое различие маловероятно получить случайно, результат считают статистически значимым.

Всё для быстрого старта в email-маркетинге:
- блочный редактор и 200 шаблонов;
- ИИ-помощник;
- 1500 писем бесплатно.
В маркетинге статистическую значимость применяют при проверке гипотез о результативности внедренных или планируемых изменений.
Статистическая значимость помогает понять, стоит ли:
- выпускать новый продукт, если тестовые продажи идут хорошо;
- менять дизайн сайта или рассылки по результатам A/B-тестирования;
- верить проведенным опросам потребителей;
- считать, что рекламная кампания оказалась эффективной, если продажи выросли.
Как определить статистическую значимость
Соберите и обработайте исходные данные. Например, при A/B-тестировании берутся данные по трафику или конверсии с альтернативных вариантов сайта.
При этом выбросы нужно проверить, чтобы понять, не искажают ли они результат. Например, посещаемость сайта колеблется в районе 100 посетителей в день. Внезапно происходит всплеск трафика до 5 000 посещений. Проверка показывает, что это результат разового фактора: сайт упомянул инфлюенсер или произошла хакерская атака. Если всплеск вызван разовым внешним фактором и не относится к исследуемому процессу, этот день можно исключить из анализа по заранее заданному правилу. Если причина неизвестна, удалять наблюдение только из-за его величины не стоит.
Репрезентативная выборка в рекламе: что это и как определить
Также нужно определить размер выборки и проследить, чтобы она была репрезентативна по отношению к генеральной совокупности.
Сформулируйте нулевую и альтернативную гипотезы. Нулевая гипотеза (H0) — принимается по умолчанию и утверждает, что разница в данных обусловлена случайностью.
Альтернативная гипотеза (H1), напротив, предполагает, что разница в данных связана с исследуемым воздействием. Анализ может дать свидетельства в её пользу, но не доказать её истинность.
Для объяснения различий между нулевой и альтернативной гипотезами в научной литературе часто используют метафору презумпции невиновности.
Презумпция невиновности принимается судом по умолчанию, поэтому соответствует нулевой гипотезе. Обвинитель же должен доказать альтернативную гипотезу, что подсудимый виновен.
Если он не может этого сделать, то это не означает, что подсудимый невиновен (нулевая гипотеза корректна). Это лишь говорит о том, что предоставленные суду данные не являются достаточно значимыми для вынесения обвинительного приговора (отклонения нулевой гипотезы).
Нулевую гипотезу отвергают или не отвергают, исходя из последующего анализа. Если она будет отвергнута, данные свидетельствуют в пользу альтернативной гипотезы.
Например, вы провели рекламную кампанию и хотите проанализировать ее результаты. Нулевая гипотеза в таком случае будет утверждать, что продажи товаров значимо не увеличились, а те изменения, которые есть, не выходят за рамки случайности. Альтернативная же будет подтверждать эффективность рекламной кампании.
Чтобы отвергнуть нулевую гипотезу, нужно показать, что увеличение сбыта товара выходит за рамки простых колебаний.
Установите уровень значимости α — максимально допустимую вероятность ошибки первого рода: отвергнуть верную нулевую гипотезу. Например, при α = 0,05 такой риск составляет 5% в серии аналогичных исследований. Чаще всего выбирают уровень 0,05, но в зависимости от задачи — 0,01 или 0,1. Порог задают до анализа данных.
Чем меньше порог значимости, тем весомее должны быть результаты для отказа от нулевой гипотезы. Например, при α = 0,01 порог строже, чем при α = 0,05: риск ошибки первого рода ниже, но при том же размере выборки выше риск не обнаружить существующий эффект.
Вычислите P-значение для числовых данных. P-значение помогает оценить, могла ли наблюдаемая разница возникнуть случайно. Чем оно меньше, тем меньше оснований объяснять результат случайностью. Например, p = 0,03 означает, что такую же или более заметную разницу получили бы случайно примерно в 3 случаях из 100.
Если p-значение меньше заранее выбранного уровня значимости, нулевую гипотезу отвергают. В таком случае результаты считаются статистически значимыми.
Для оценки статистической значимости применяют разные методы, в том числе доверительный интервал и t-критерий. Они помогают понять, достаточно ли различаются показатели сравниваемых групп, например конверсия в вариантах A и B, чтобы отвергнуть нулевую гипотезу. Подробнее эти методы разберём в примере ниже.
Существуют и другие способы определить P-значение: Z-тест, F-Test и так далее.
Также можно использовать готовые калькуляторы, чтобы определить, насколько значим полученный результат.
Так, калькулятор от Яндекса помогает рассчитать результаты A/B-тестирования в Яндекс Директе. Другой калькулятор позволяет выяснить размер выборки и провести t-тест при A/B-тестировании.
Сделайте выводы. Если P-значение меньше заранее заданного уровня значимости, нулевую гипотезу отвергают. В противном случае нулевую гипотезу не отвергают: данных недостаточно, чтобы отделить эффект от случайных колебаний.
Пример вычисления статистической значимости
Допустим, маркетолог хочет оценить, стоит ли менять старый дизайн упаковки товара на новый. У него есть данные о продажах, которые вроде как подтверждают, что обновленный продукт покупают чаще. Задача — оценить, насколько статически значимы полученные результаты.
Для примера возьмем средние ежедневные результаты тестовых продаж нового продукта (доступны за неделю). С ними сравниваются аналогичные продажи старой версии продукта, которые доступны за год. Это упрощённое сравнение с историческими данными: в реальном эксперименте надёжнее одновременно сравнивать случайно сформированные контрольную и тестовую группы.
| Среднее число продаж новой версии товара (единиц, в день) | 400 |
| Среднее число продаж старой версии товара (единиц, в день) | 340 |
| Стандартная ошибка | 35 |
| Число дней тестирования (размер выборки) | 7 |
Стандартная ошибка показывает, насколько может колебаться выборочное среднее при повторных выборках.
Для вычисления стандартной ошибки нужно определить стандартное отклонение, а потом разделить его на корень объема выборки.
Проверка данных. Маркетолог проверяет полученные данные, убеждается, что в них нет выбросов или следов манипуляций.
Формулировка гипотез. Нулевая гипотеза (H0) утверждает, что разница в продажах обусловлена случайностью, средние продажи старой и новой версии товаров не отличаются на более длительном интервале.
Альтернативная гипотеза (H1) утверждает, что разница продаж является результатом обновления продукта. Отличие средних величин продаж является статистически значимым.
Выбор уровня значимости. Маркетолог устанавливает стандартный уровень значимости в 0,05.
Вычисление P-значения. Решить задачу можно с помощью доверительных интервалов и t-критерия Стьюдента. Оба метода должны подтверждать результаты друг друга.
В первом случае нужно проверить, входит ли значение из нулевой гипотезы в 95%-ный доверительный интервал. Если входит, нулевую гипотезу не отвергают; если не входит — отвергают (при уровне значимости 0,05).
Порядок действий следующий:
- Находим степень свободы (для одной выборки этот показатель равен числу наблюдений минус единица): 7 - 1 = 6.
- Используем t-таблицу для поиска значения t. Смотрим пересечение уровня значимости 0,05 и степени свободы 6. Находим число 2,447.
- Следом находим доверительный интервал 95%. Для этого нужно прибавить и отнять от среднего числа продаж новой версии (400) произведение числа 2,447 на ст. ошибку (35). Получим 400 - (2,447*35) = 314 и 400 + (2,447*35) = 486. В Excel вычисляется при помощи функции ДОВЕРИТ.
- Интерпретируем полученные числа следующим образом: присутствует 95% уверенность, что среднее количество продаж обновленного продукта будет в границах между 314 и 486 единицами.
- Видно, что среднее число продаж старого продукта (340), которое по нулевой гипотезе незначительно отличается от показателей обновленной версии, входит в данный интервал. Поэтому данных недостаточно, чтобы отвергнуть нулевую гипотезу. Если бы значение было выше или ниже интервала, то можно было бы сделать статически значимый вывод, что среднее число продаж новой версии товара лучше (хуже) продаж старой версии.
Второй метод заключается в в вычислении t-критерия для имеющихся данных. Сравниваем полученное значение t-критерия (1,71) со значением из t-таблицы (2,447). Если рассчитанное значение меньше табличного, нулевую гипотезу не отвергают; если больше — отвергают. В Excel вычисляется при помощи функции СТЬЮДЕНТ.ТЕСТ.
Алгоритм вычисления:
- Для вычисления t-критерия вычитаем из нового среднего старый показатель и делим на ст. ошибку. (400 - 340) / 35 = 1,71.
- Видим, что найденное значение меньше значения из t-таблицы (2,447).
- Мы не можем отвергнуть нулевую гипотезу. Если бы найденное значение t-критерия оказалось выше значения из таблицы, нулевую гипотезу следовало бы отвергнуть.
Подставляем t = 1,71 и 6 степеней свободы в калькулятор p-value для двустороннего t-теста и получаем p ≈ 0,137. Это выше уровня значимости 0,05, поэтому нулевую гипотезу не отвергают.
Выводы. Можно ли считать, что продажи новой версии товара не имеют смысла? Нет, просто представленные данные не позволяют сделать статистически значимый вывод о его преимуществах. Возможно, нужно расширить выборку: взять результаты за более длительный период времени.
Главные ошибки при расчете статистической значимости
Учитывать не все результаты вычислений (p-hacking). Случаи, когда P-значение не позволяет подтвердить альтернативную гипотезу, отбрасываются. Эта проблема довольно часто возникает, если исследователь хочет любой ценой подтвердить, что его выводы статистически значимы.
Допустим, маркетолог вложил много сил и времени в создание альтернативного варианта сайта. Он проводит A/B-тестирование, но получает, что P > 0,05. Альтернативная гипотеза об эффективности нового сайта не подтверждается. Однако показатель P очень близок к 0,05. Возникает искушение использовать p-хакинг. Если продолжать набирать наблюдения без заранее заданного правила остановки или делить аудиторию на сегменты, пока в одном из них не появится P < 0,05, это будет p-хакинг.
Сначала вычислить P-значение, а потом подогнать уровень надежности. Это позволяет манипулировать результатами проверки гипотез. Например, после вычислений P-значение получилось 0,08. При заранее выбранном α = 0,05 нулевую гипотезу не отвергают. Нельзя после анализа повысить α до 0,1 только для того, чтобы объявить результат статистически значимым.
Считать прошлые результаты универсальными. Не нужно думать, что найденная статистическая значимость или её отсутствие на 100% гарантируют будущие результаты. К примеру, A/B-тест показал преимущество нового дизайна. Сайт модернизировали, он показывает хорошие результаты, но потом цифры идут вниз. Почему? Причин может быть много: от действий конкурентов до ошибок выборки, на которой тестировался новый дизайн.
Выбрать уровень значимости без учёта последствий ошибок. При α = 0,1 выше риск ошибки первого рода — обнаружить эффект, которого на самом деле нет. При α = 0,01 порог строже, поэтому при том же размере выборки возрастает риск ошибки второго рода — не обнаружить существующий эффект.
Прежде чем принимать решение на основе статистической значимости, важно понимать, что она не отображает силу связи. Например, версия сайта А более результативна, чем В. Но насколько? Если сайт после модернизации посещают больше людей, то оправдывает ли этот прирост сделанные вложения? Это должно быть предметом отдельного анализа.
Кроме того, если статистическая значимость не доказана, это не означает, что нулевая гипотеза верна. Это лишь показывает, что данных недостаточно для её опровержения. Маркетолог может попробовать провести новые тесты, но тут возникает опасность манипулирования данными.
Главные мысли